


Power BI Dataflows lohnen sich für alle, die ETL-Logik nicht in jedem Bericht neu bauen wollen. Für neue Projekte empfiehlt sich klar Dataflow Gen2 auf Microsoft Fabric, denn die Plattform bietet AutoSave, mehrere Zielspeicher und eine bessere Überwachung als die Vorgängerversion. Der eigentliche Gewinn liegt in der wiederverwendbaren Transformationslogik: einmal bauen, überall konsumieren. Wer zusätzlich inkrementelle Aktualisierung nutzt, spart erheblich an Rechenzeit und Wartezeit bei jedem Refresh.
Kurz gesagt:
- Power BI Dataflows bieten zentrale, wiederverwendbare ETL-Logik, um Mehrfachnutzung und Konsistenz in Berichten zu gewährleisten, besonders bei großen Datensätzen.
- Die aktuelle Empfehlung lautet, direkt mit Dataflow Gen2 auf Microsoft Fabric zu starten, da es bessere Monitoring- und Speicheroptionen sowie AutoSave bietet.
- Für komplexe, organisationsweite Projekte mit mehreren Teams und großen Datenmengen sind Dataflows besonders lohnenswert, während sie bei kleinen Einzelnutzungen oft unnötig sind.
- Inkrementelle Aktualisierung verkürzt die Rechenzeit erheblich, erfordert allerdings eine verlässliche Zeitstempelspalte und ist in Gen2 kostenintensiver, wenn keine Fabric- oder Premium-Kapazität vorhanden ist.
- Die Verwaltung der Zugriffsrechte erfolgt über Power BI Workspaces, wobei eine klare Trennung der Daten- und Implementierungsschichten die Fehlerquelle minimiert und Migrationen vereinfacht.
Inhaltsverzeichnis
- Was sind Power BI Dataflows und wofür braucht man sie?
- Gen1 oder Gen2: Welche Version sollten Sie wählen?
- Für welche Projekte lohnen sich Dataflows wirklich?
- Dataflow erstellen und konfigurieren: die Praxis-Checkliste
- Wie optimieren Sie Dataflows in der Praxis?
- Wie geht IT-WINGS bei Dataflow-Projekten vor?
- Sicherheits- und Zugriffsverwaltung bei Power BI Dataflows
- Was kosten Power BI Dataflows in der Praxis?
- Wie lassen sich Dataflows mit anderen Systemen verbinden?
- Redaktionelle Perspektive: Wie wichtig sind Dataflows wirklich für Ihre BI-Architektur?
- IT-WINGS begleitet Sie bei Dataflow-Aufbau und Gen2-Migration
- Quellen
- FAQ
Was sind Power BI Dataflows und wofür braucht man sie?
Ein Dataflow ist im Kern eine Self-Service-Datenvorbereitung, die mit Power Query arbeitet und ETL-Logik zentral definiert. Statt dass fünf Berichte fünf Mal dieselbe Bereinigung durchführen, liegt die Logik einmal im Dataflow und wird von allen Modellen abgerufen. Genau das macht Power BI Dataflows zu einem Governance-Werkzeug, nicht nur zu einem technischen Feature: Sie verhindern, dass in jedem Team eine eigene Version der „Wahrheit“ entsteht.
Wo die Daten am Ende landen, hängt vom gewählten Speicherziel ab:
- Interner Dataflow-Speicher innerhalb von Power BI, der einfachste Einstieg ohne Zusatzkonfiguration.
- Azure Data Lake Storage Gen2, wenn Dataflows auch außerhalb von Power BI von anderen Azure-Diensten genutzt werden sollen.
- Fabric-Ziele wie Lakehouse oder Warehouse, die direkte Integration in eine größere Data-Engineering-Umgebung erlauben.
Der Nutzen ist damit doppelt: geringere Belastung der Quellsysteme, weil nicht jeder Bericht einzeln abfragt, und eine echte Single Source of Truth für Kennzahlen, die in mehreren Abteilungen verwendet werden.
Gen1 oder Gen2: Welche Version sollten Sie wählen?
Dataflow Gen1 gilt inzwischen als Legacy-Technologie. Microsoft investiert die neuen Funktionen fast ausschließlich in Gen2, das tief in Microsoft Fabric integriert ist. Gen2 bringt AutoSave, Hintergrund-Publishing, mehrere Ausgabeziele gleichzeitig und ein deutlich besseres Monitoring mit. Wer heute neu startet, sollte sich die Migrationsdiskussion später sparen und direkt mit Gen2 beginnen.
Ein Lizenzhinweis gehört zwingend dazu: Volle Gen2-Funktionalität setzt eine Fabric- oder Premium-Kapazität voraus. Mit reinen Pro- oder PPU-Lizenzen bleiben Sie eingeschränkt, etwa bei der inkrementellen Aktualisierung oder bei größeren Datenvolumen.
Für den Umstieg von bestehenden Gen1-Dataflows gibt es drei praktikable Wege:
- Save As direkt in eine Gen2-Umgebung übertragen, wenn die Struktur einfach ist.
- Export und Import von Power Query-Vorlagen (PQT), wenn Sie die Logik gezielt prüfen wollen.
- Copy & Paste einzelner Queries, wenn nur Teile eines Dataflows übernommen werden sollen.
Für welche Projekte lohnen sich Dataflows wirklich?
Dataflows entfalten ihren Wert dort, wo mehrere Berichte oder Teams dieselbe Rohdatenbasis brauchen. Ein Konzern mit fünf Ländergesellschaften, die alle denselben Kundenstamm bereinigen müssen, profitiert enorm von der zentralen Logik. Auch bei großen Datenmengen zahlt sich die Trennung von Rohdaten, Zwischenschicht und Reporting aus.
Weniger sinnvoll sind Dataflows bei kleinen, einmaligen Analysen ohne Wiederverwendungswert. Wer für einen einzigen Bericht eine Excel-Tabelle mit 500 Zeilen aufbereitet, braucht keine zusätzliche Architekturebene.
Operativ hilft eine klare Trennung zwischen vier Schichten:
- Ingestion: Rohdaten unverändert aus der Quelle holen.
- Staging: erste Bereinigung, Typumwandlung, Deduplizierung.
- Computed Entities: Geschäftslogik, Verknüpfungen, abgeleitete Kennzahlen.
- Consumption: fertige Tabellen, die Berichte direkt einbinden.
Profi-Tipp: Bauen Sie niemals Geschäftslogik direkt in die Ingestion-Schicht. Wenn sich eine Quelle ändert, müssen Sie sonst jede nachgelagerte Regel neu suchen statt sie an einer Stelle anzupassen.
Dataflow erstellen und konfigurieren: die Praxis-Checkliste
Bevor Sie den ersten Dataflow anlegen, klären Sie die Berechtigungslage. Mit einer reinen Pro-Lizenz stehen Ihnen weniger Optionen offen als mit PPU oder einer Premium-/Fabric-Kapazität, besonders bei Refresh-Häufigkeit und inkrementeller Aktualisierung.
So gehen Sie in der Praxis vor:
- Workspace prüfen: Kapazitätstyp und Rollen der Beteiligten festlegen, bevor der erste Query geschrieben wird.
- Quelle auswählen: neue Verbindung („New source“), verknüpfte Tabellen (Linked Entities), berechnete Tabellen (Computed Entities) oder ein CDM-Ordner für Import und Export.
- Transformationen definieren: Power-Query-Schritte anlegen, dabei früh auf Folding-Fähigkeit achten.
- Refresh konfigurieren: Zeitplan, Compute Engine und gegebenenfalls inkrementelle Buckets festlegen.
- Dataflow konsumieren: aus Power BI Desktop oder direkt aus Fabric-Ressourcen anbinden.
Bei der Konfiguration lohnt sich ein zweiter Blick auf drei Stellschrauben:
- Compute Engine: On, Optimized oder Off. Optimized nutzt zwischengespeicherte Daten intelligenter und beschleunigt nachgelagerte Computed Entities.
- DirectQuery versus Import: Import ist meist performanter, DirectQuery hält Daten aktueller, kostet aber Reaktionszeit.
- Refresh-Chaining: Reihenfolge der Aktualisierungen so planen, dass abhängige Dataflows nicht auf veralteten Daten aufsetzen.
Wie optimieren Sie Dataflows in der Praxis?
Query Folding entscheidet darüber, ob ein Dataflow schnell bleibt oder zum Nadelöhr wird. Folding bedeutet, dass Power Query Transformationsschritte an die Quelldatenbank delegiert, statt sie im Arbeitsspeicher der Dataflow-Engine auszuführen. Ohne Folding wird selbst ein mittelgroßer Dataflow träge. Ob Folding aktiv ist, sehen Sie am Compute-Status in der Refresh History, wo Zustände wie „Cached“ oder „Folded“ angezeigt werden. Prüfen Sie nach jedem größeren Transformationsschritt, ob dieser Status kippt.
Für die inkrementelle Aktualisierung brauchen Sie eine verlässliche Zeitstempelspalte, an der sich neue oder geänderte Zeilen erkennen lassen. In Gen2 funktioniert das über ein bucketbasiertes Modell, bei dem nur geänderte Buckets parallel verarbeitet werden, was Rechenzeit und Wartezeit deutlich senkt. In Gen1 ist dieselbe Funktion an eine Premium- oder PPU-Lizenz gebunden.
Für laufenden Betrieb gehören diese Punkte auf jede Checkliste:
- Refresh History regelmäßig auf Fehlermuster und Laufzeitsprünge prüfen.
- Compute-Status nach jedem Schema-Update neu kontrollieren.
- Orchestrierung mehrerer Dataflows über die Power BI REST API oder Power Automate steuern, statt manuell zu klicken.
Dataflows unterstützen laut Microsoft bis zu 48 geplante Aktualisierungen pro Tag. Wer diesen Rahmen ausschöpfen will, sollte Refresh-Zeiten so staffeln, dass abhängige Computed Entities nicht auf halbfertigen Daten aufbauen.
Wie geht IT-WINGS bei Dataflow-Projekten vor?
Vor dem eigentlichen Bau eines Dataflows steht bei uns eine hypothesenbasierte Prüfung der Quellen: Welche Systeme liefern saubere, konsistente Daten, und wo ist mit Foldbarkeit überhaupt zu rechnen? Diese Vorabklärung spart später Wochen an Nachbesserung.
Ebenso wichtig ist die strikte Trennung zwischen Ingestion und Transformation. Rohdaten wandern unverändert in eine Staging-Schicht, Geschäftslogik entsteht ausschließlich in separaten Computed Entities. Diese Struktur macht Fehlerursachen leichter auffindbar und Migrationen zwischen Gen1 und Gen2 unkomplizierter, weil sich einzelne Schichten unabhängig austauschen lassen.
Ein Dataflow, der Rohdaten und Geschäftslogik vermischt, wird bei jedem Quellwechsel zur Baustelle. Wer beide Ebenen trennt, tauscht später nur eine Schicht aus, nicht die ganze Architektur.
In der Praxis zeigt sich das etwa bei Migrationsprojekten von Gen1 zu Gen2, bei Monitoring-Dashboards für Refresh-Zuverlässigkeit oder bei gezieltem Performance-Tuning einzelner Compute-Schritte.
Sicherheits- und Zugriffsverwaltung bei Power BI Dataflows
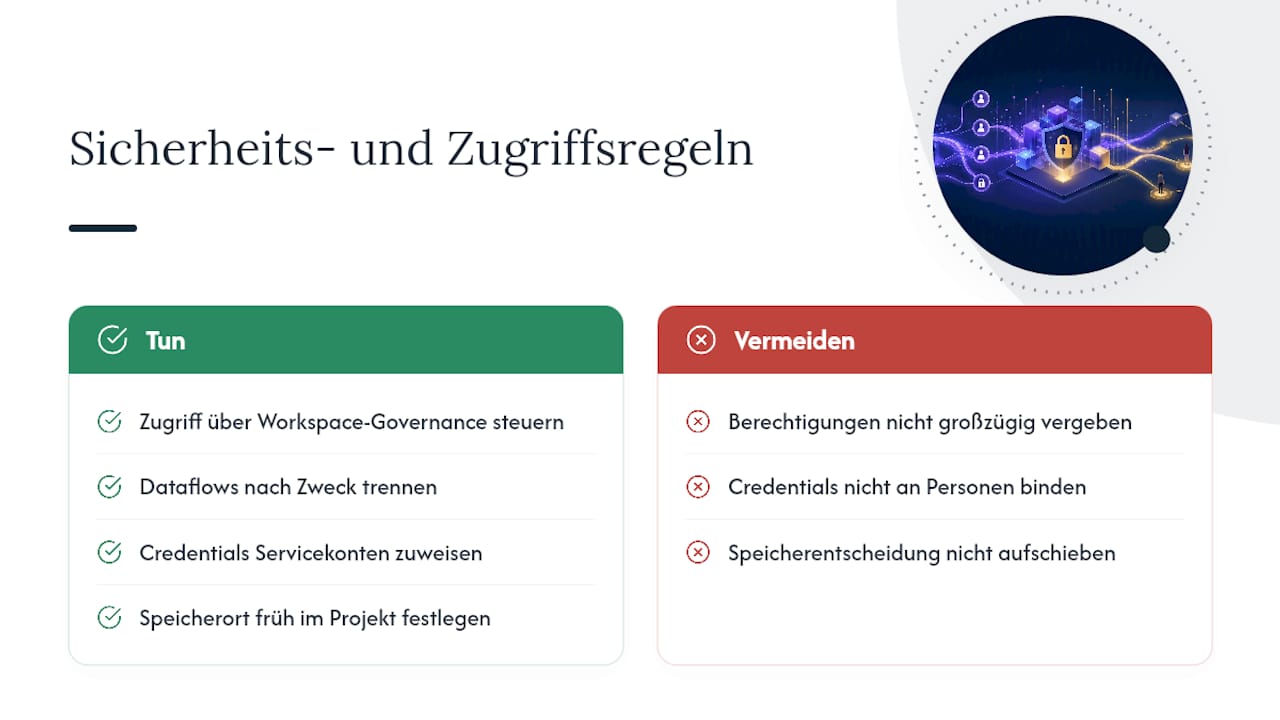
Zugriffsrechte auf Dataflows folgen der Workspace-Struktur von Power BI. Wer Mitglied oder Mitwirkender eines Workspace ist, kann die dort liegenden Dataflows sehen, bearbeiten oder aktualisieren, je nach zugewiesener Rolle. Das bedeutet in der Praxis: Dataflow-Sicherheit ist kein separates System, sondern hängt direkt an der Workspace-Governance Ihrer Organisation.
Für sensible Daten lohnt sich eine bewusste Trennung nach Workspace-Zweck. Ein Dataflow mit Personalkennzahlen gehört in einen anderen Workspace als ein Dataflow mit öffentlichen Marktdaten, selbst wenn dieselben Analysten beide nutzen. So verhindern Sie, dass eine großzügig vergebene Berechtigung versehentlich Zugriff auf Daten öffnet, die eigentlich abgeschottet sein sollten.
Bei Verbindungen zu externen Quellen kommt die Verwaltung von Anmeldeinformationen (Credentials) hinzu. Diese werden zentral über Datengateways oder Cloud-Verbindungen verwaltet und sollten nicht an einzelne Personen, sondern an Servicekonten gebunden sein. Verlässt eine Person das Team, bleibt der Dataflow trotzdem funktionsfähig.
Für regulierte Branchen ist zusätzlich relevant, wo Daten physisch liegen. Bei ADLS-Gen2-Speicherzielen bestimmen Sie den Speicherort selbst, während der interne Power-BI-Speicher an die Region Ihres Mandanten gebunden ist. Wer strenge Vorgaben zur Datenaufbewahrung hat, etwa aus regulatorischen Gründen vergleichbar mit Fragen der GA4-Datenaufbewahrung im Web-Tracking, sollte diese Speicherentscheidung früh im Projekt treffen, nicht nachträglich.
Was kosten Power BI Dataflows in der Praxis?
Dataflows selbst sind kein separat bepreistes Produkt, sondern eine Funktion, die an bestehende Power-BI-Lizenzen gekoppelt ist. Die Kosten entstehen also nicht durch den Dataflow an sich, sondern durch die Lizenzstufe, die Sie für die gewünschten Funktionen brauchen.
Mit einer Pro-Lizenz pro Person lassen sich einfache Dataflows bauen und aktualisieren, allerdings ohne inkrementelle Aktualisierung und mit engeren Grenzen bei Datenvolumen und Aktualisierungshäufigkeit. Premium Per User (PPU) erweitert diese Grenzen und schaltet einige Premium-Funktionen frei, bleibt aber an einzelne Nutzer gebunden.
Der eigentliche Sprung passiert bei Premium-Kapazität oder einer Fabric-Kapazität: Hier zahlen Sie für Rechenleistung, die sich auf viele Nutzer verteilt, statt pro Kopf zu lizenzieren. Für Organisationen mit vielen Dataflow-Nutzern wird das oft günstiger als eine wachsende Zahl von PPU-Lizenzen. Zusätzlich fallen bei ADLS-Gen2-Speicherzielen separate Azure-Speicherkosten an, die getrennt von der Power-BI-Lizenz abgerechnet werden.
Wer noch unsicher ist, welches Lizenzmodell zur eigenen Datenmenge und Nutzerzahl passt, sollte diese Entscheidung nicht allein technisch treffen. Ein kurzer Blick auf die tatsächliche Refresh-Frequenz und die Anzahl paralleler Dataflow-Projekte verhindert eine teure Fehlentscheidung zwischen PPU und Kapazitätslizenz.
Wie lassen sich Dataflows mit anderen Systemen verbinden?
Dataflows sind kein isoliertes Werkzeug innerhalb von Power BI, sondern ein Baustein der gesamten Power Platform. Power Automate kann auf Dataflow-Aktualisierungen reagieren oder sie auslösen, etwa um einen Refresh erst zu starten, wenn eine vorgelagerte Quelle bestätigt neue Daten geliefert hat. Power Apps kann wiederum auf Tabellen zugreifen, die aus einem Dataflow stammen, ohne dass Entwickler die Transformationslogik doppelt bauen müssen.
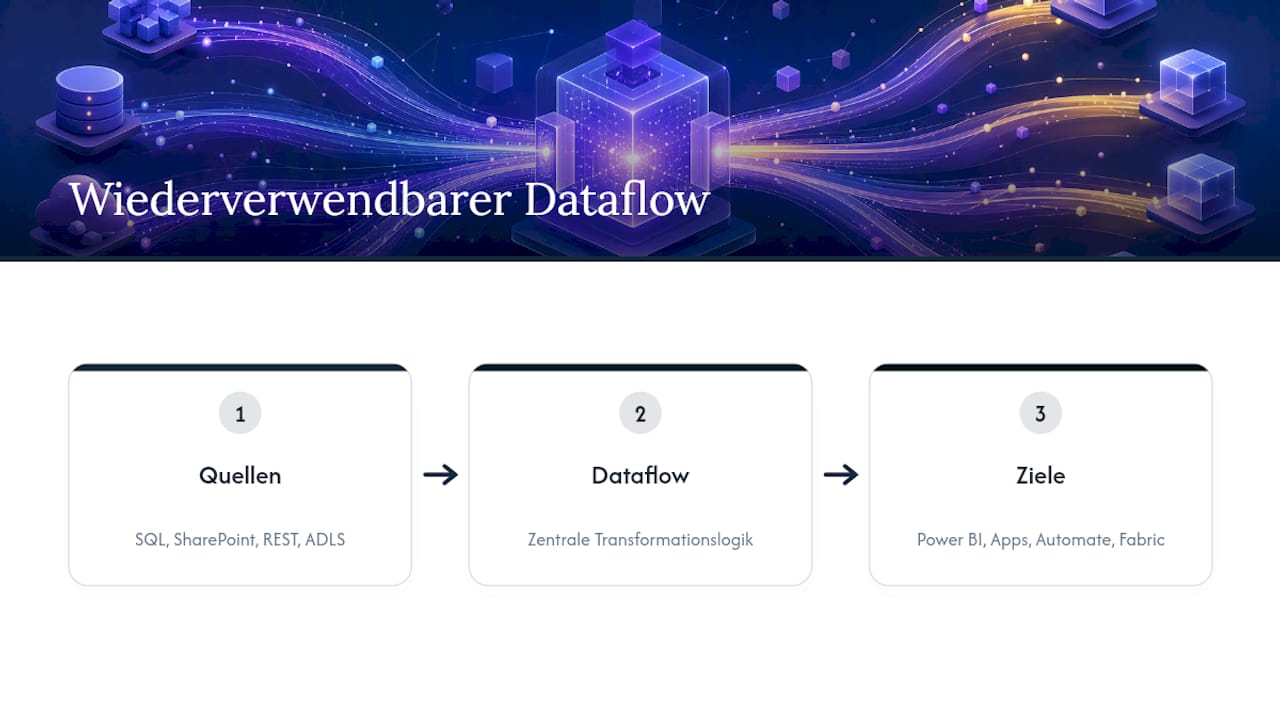
Bei externen Datenquellen zeigt sich die Stärke von Dataflows besonders deutlich. Ob SQL-Datenbank, SharePoint-Liste, REST-API oder Cloud-Speicher wie ADLS Gen2, die Verbindungslogik lässt sich einmal bauen und von mehreren nachgelagerten Systemen nutzen. Das reduziert die Zahl der Punkt-zu-Punkt-Verbindungen, die sonst zwischen jeder Quelle und jedem Zielsystem einzeln gepflegt werden müssten.
Für Teams, die bereits mit externen Analysewerkzeugen arbeiten, lohnt sich ein Blick auf Praxisbeiträge zu Tracking- und Dashboard-Aufbau, die zeigen, wie ähnliche Prinzipien der Wiederverwendbarkeit auch außerhalb von Power BI funktionieren. Innerhalb von Microsoft Fabric geht die Integration noch weiter: Ein Gen2-Dataflow kann direkt in ein Lakehouse schreiben, das anschließend von Data-Engineering-Pipelines, Notebooks oder anderen Fabric-Komponenten weiterverarbeitet wird, ganz ohne Umweg über einen zusätzlichen Export-Schritt.
Redaktionelle Perspektive: Wie wichtig sind Dataflows wirklich für Ihre BI-Architektur?
Dataflows sind kein Nischenfeature, sondern ein Hebel gegen Datensilos. Wer jetzt investiert, sollte direkt auf Gen2 setzen, die Performance der Quellsysteme aber vorher ehrlich prüfen. Externe ETL-Tools oder reine Datasets bleiben legitime Alternativen, ersetzen aber selten die Governance-Wirkung zentraler Dataflows.
— Armin Sanjari
IT-WINGS begleitet Sie bei Dataflow-Aufbau und Gen2-Migration
Als Digital Analytics Agentur mit Sitz in Stuttgart übernehmen wir genau die Arbeit, die zwischen technischer Machbarkeit und stabiler Datenpipeline liegt: Quellenanalyse, Foldbarkeitsprüfung, Aufbau der Ingestion- und Transformationsschichten und die Migration bestehender Gen1-Dataflows nach Fabric.

Als spezialisierte Data Engineering-Agentur bauen wir Dataflows so, dass sie auch bei wachsender Datenmenge stabil bleiben, inklusive Monitoring-Setup für Refresh History und Compute-Status. Ergänzend übernehmen wir das Dashboarding, damit die aufbereiteten Daten auch sichtbar Wirkung entfalten, statt nur technisch korrekt im Hintergrund zu liegen. Vereinbaren Sie ein Erstgespräch über unsere Seite zu Data Engineering, und wir prüfen gemeinsam, ob Ihre aktuelle Dataflow-Architektur bereits auf Gen2 vorbereitet ist oder wo Nachholbedarf besteht.
Quellen
- Differences between Dataflow Gen1 and Dataflow Gen2 – Microsoft Fabric | Microsoft Learn
- Announcing Public Preview: Incremental Refresh in Dataflow Gen2
FAQ
Ist Power BI schwer zu lernen?
Die Grundfunktionen sind mit etwas Excel-Erfahrung schnell verständlich, Power Query und Dataflows brauchen aber Einarbeitung in Transformationslogik und Datenmodellierung. Wer bereits mit ETL-Konzepten vertraut ist, kommt deutlich schneller voran als Einsteiger ohne Datenbank-Hintergrund.
Was kann Power BI, was Excel nicht kann?
Power BI trennt Datenmodell, Transformationslogik und Visualisierung, sodass sich große, mehrdimensionale Datenmengen performant analysieren lassen, ohne dass Formeln in Tausenden Zellen wiederholt werden. Dataflows gehen noch einen Schritt weiter: Sie zentralisieren ETL-Logik so, dass mehrere Berichte dieselbe bereinigte Datenbasis nutzen, was in Excel praktisch nicht abbildbar ist.
Wie erkläre ich Power BI Dataflows einfach?
Ein Dataflow ist ein zentraler Aufbereitungsschritt, der Rohdaten einmal bereinigt und transformiert, bevor sie in Berichte fließen. Statt dass jeder Bericht seine eigene Datenputzarbeit macht, greifen alle auf dieselbe fertige Tabelle zu, was Konsistenz und Wiederverwendbarkeit sichert.
Was macht Power BI genau?
Power BI verbindet sich mit Datenquellen, bereitet die Daten über Power Query auf, baut daraus ein Datenmodell mit Beziehungen und Kennzahlen und stellt die Ergebnisse in interaktiven Berichten dar. Dataflows sind dabei der Baustein, der die Aufbereitungsschicht von der Modellierung und Visualisierung trennt.
Brauche ich für Dataflows eine Premium-Lizenz?
Grundlegende Dataflows funktionieren bereits mit einer Pro-Lizenz, doch inkrementelle Aktualisierung und höhere Datenvolumen setzen Premium Per User oder eine Fabric-/Premium-Kapazität voraus. Wer die Details zur passenden Lizenzstrategie klären möchte, findet Unterstützung über die Data-Engineering-Leistungen einer spezialisierten Agentur.